
本文
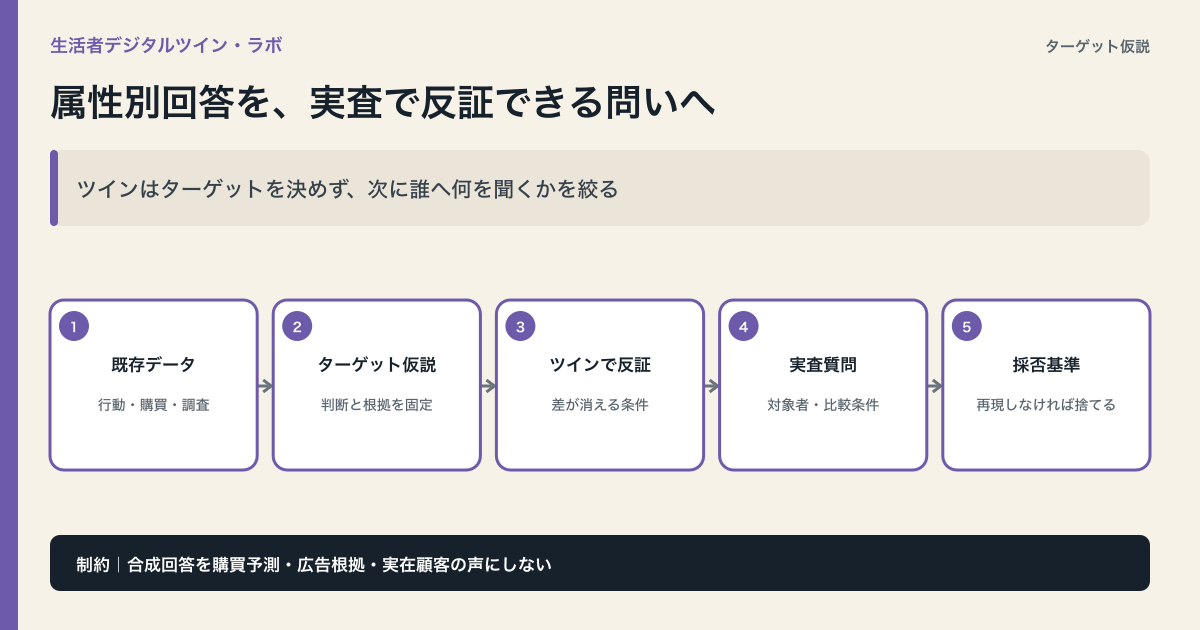
生活者デジタルツインは、ターゲットを決める答えを出す装置ではありません。使うべき場面は、既存データから作った複数のターゲット仮説を比べ、「次に誰へ、何を聞くべきか」を速く絞るときです。属性別の合成回答が違ったとしても、それだけで市場の差や購買意向の差が証明されたわけではありません。実査へ渡す仮説に変換して初めて、意思決定に使える材料になります。
最初に固定するのは三つです。第一に、何を判断するのか。たとえば「新規顧客を優先するか、既存顧客の再購入を優先するか」です。第二に、比較するセグメントを、利用履歴・購買データ・インタビューなど実在の根拠で定義します。年齢や職業だけで、もっともらしい人物像を量産しないことが大切です。第三に、実査でどの結果なら仮説を捨てるかを先に決めます。
その上でツインには、二つの仮説の違いを説明させるのではなく、差が消える条件と反対意見を出させます。たとえば価格重視層と利便性重視層を比べるなら、「どちらが買うか」を問うだけでは不十分です。「価格差がいくらなら選択が反転するか」「購入を止める不安は何か」「既存のデータで裏付けられていない前提は何か」を問います。出力はランキングではなく、実査で検証する質問、対象者、反証条件の一覧にします。
この慎重さには理由があります。市場調査でのLLM利用を検討した研究は、支払意思額の推定が人の調査と近い場合がある一方、不正確だったり符号まで逆になったりする場合を報告しています。さらに、既存データでの調整は同じ商品カテゴリー・母集団では改善しても、新しいカテゴリーや顧客セグメント間の違いでは同様に改善しませんでした[1]。2026年の査読前preprintによる横断ベンチマークも、属性プロンプトを与えた合成回答がセグメント間の差を過大にし得ることを示しています[2]。最終的な査読結果や追試で評価が変わり得るため、運用の上限を決める証拠として使います。
一方で、限定された条件で人の回答分布へ近づく可能性を示す研究もあります。パーソナルケアの57調査、9,300件の人回答と比較した研究では、数値を直接答えさせず文章反応から尺度へ写像する手法が、人の再テスト信頼性に近い結果を報告しました[3]。これは「どのツインでも実査が不要」という結論ではなく、対象カテゴリー、元データ、質問形式、評価指標をそろえて検証すべきことを示します。別の査読前preprintでは、選好の異質性や現状維持・拒否の分布を十分に再現できず、合成サンプルは人回答の代替ではないと結論づけています[4]。
実務では、ツインの結果を一枚にまとめます。左に「仮説」と根拠データ、中央に「ツインが出した反対仮説・未確認条件」、右に「実査質問・必要な対象者・採否基準」を置きます。例えば「若年層が主ターゲット」という仮説に対して、ツインが価格不安を示したなら、実査では年齢差そのものではなく、価格帯、購入頻度、代替手段をそろえて確認します。差が実査で再現されなければ、ターゲット戦略ではなくツイン側の仮説を捨てます。
海外では、Prophetがアスレジャーブランドtascで、観測済みの行動データを含むデジタルツインを使い、優先セグメントと制作物を検討した事例を公開しています。同社はAI由来の示唆を顧客チームの知見と照合して判断リスクを下げたと説明しています[5]。これは有用な運用例ですが、掲載された成長機会は推定値であり、ツインだけが因果的に成果を生んだ証明ではありません。
また、合成生活者の発言を実在顧客の声のように外部へ見せたり、広告の実証根拠に使ったりしてはいけません。欧州委員会は2026年7月20日にAI Act第50条の最終ガイドラインを公表し、同条の透明性義務は8月2日から適用されています[6]。本稿に関係する主な対象には、生成物の機械可読な標識、deepfake、公共の利益に関する一定のAI生成テキストなどがあり、あらゆる合成生活者の内部利用や外部提示を一律に規律するものではありません[7]。日本での広告表示や公開の適法性は、AI Actから推論せず、日本の表示規制、個人情報、契約、表示文脈を別に確認します。
生活者デジタルツインの役割は、実査を置き換えることではなく、実査で聞くべき差と外してはいけない反証を先に見つけることです。まずは一つのターゲット判断に限定し、合成回答と実査結果のずれを次の設計へ戻すところから始めましょう。
実査は大規模である必要はありません。最初の目的が「どの層へ投資すべきか」の確認なら、ツインで差が出た条件を意図して含めた小規模のインタビューや試験調査から始められます。重要なのは、ツインの結論に合う回答だけを集めないことです。購入しない人、乗り換えない人、対象外と考えた人の理由を同じ質問で聞き、想定外の条件が出たら仮説表へ戻します。
会議で見る数値も二つに分けます。一つはツインが作った仮説の量、もう一つは実査で支持または否定された割合です。前者が多いことは市場理解の証拠ではありません。後者が低ければ、属性の切り方、元データ、質問文、モデル設定のどこがずれたかを調べます。この差分を次回のツイン設計へ戻すことで、速い発散と実在生活者による検証を同じ学習ループにできます。
一次情報と確認範囲
確認日:2026年9月17日。製品仕様・制度は更新されるため、導入時はリンク先の最新版を再確認してください。海外の制度・職業規範は日本へ直接適用せず、相違点と限界を本文に明記しています。